Über viele Jahre haben wir argumentiert, dass sich die Herausforderungen des Wissensmanagements nicht allein durch immer ausgefeiltere Ablagestrukturen lösen lassen. Stattdessen ging es darum, Wissen aus den Silos zu holen, Menschen miteinander zu vernetzen und den Wissensaustausch unmittelbar in die Zusammenarbeit zu integrieren.
Social Intranets, Enterprise Social Networks, Communities of Practice und Social Collaboration standen für diesen Perspektivwechsel. Dahinter stand die Erkenntnis, dass organisationales Wissen nicht allein in Dokumenten und Datenbanken liegt, sondern auch in den Erfahrungen der Menschen, ihren Beziehungen und der gemeinsamen Bearbeitung von Aufgaben entsteht. Wissensmanagement sollte deshalb die Bedingungen verbessern, unter denen Wissen geteilt und neues Wissen geschaffen wird. Wie sich dieser Bogen von Enterprise 2.0 bis zur KI-gestützten Arbeit entwickelt hat, haben wir in acht Phasen der digitalen Zusammenarbeit eingeordnet.
Jetzt kommt KI, und plötzlich diskutieren wir wieder über Informationsarchitekturen, Metadaten, Taxonomien, Dokumentenqualität und Governance. Müssen wir also zurück zu einer stärker strukturierten Wissensorganisation, nachdem wir jahrelang die Öffnung der Informationssilos propagiert haben?
Diese Frage hat mit agentischer Arbeit zusätzlich an Bedeutung gewonnen. In den ersten beiden Teilen unserer Serie From Knowledge Work to Agentic Work haben wir beschrieben, wie sich menschliche Arbeit von der unmittelbaren Ausführung zur Beauftragung, Steuerung und Bewertung verlagern kann und warum daraus neue Anforderungen an die Orchestrierung von Arbeitssystemen entstehen.
Für beide Entwicklungen ist entscheidend, auf welcher Wissensgrundlage Agenten arbeiten. In vielen Unternehmen haben sich Microsoft Teams, SharePoint und andere Kollaborationsplattformen zu umfangreichen, dezentral gewachsenen Informationslandschaften entwickelt. Mitarbeitende gleichen deren Unübersichtlichkeit häufig durch Erfahrungswissen, persönliche Kontakte und Rückfragen aus. KI-Assistenten und Agenten verarbeiten dagegen verfügbare Informationsbestände auch außerhalb ihres ursprünglichen Entstehungskontexts. Bisher tolerierte Probleme der Informationsordnung können dadurch neue Auswirkungen auf die Qualität der Arbeit bekommen.
Warum KI die Probleme gewachsener Informationslandschaften verschärft
Das Thema beschäftigt inzwischen auch die Wissensmanagement-Community. Das KnowledgeCamp 2026 der Gesellschaft für Wissensmanagement stand am 8. und 9. Oktober unter dem Motto „KM in the AI era“. Eine der drei Leitfragen war, wie Wissensmanagement dazu beitragen kann, dass KI besser funktioniert: durch Datenqualität, Taxonomien und Wissensgraphen, also maschinenlesbare Netze aus Begriffen und ihren Beziehungen.
Damit verändert sich die Blickrichtung. In den vergangenen Jahren haben wir vor allem darüber gesprochen, wie KI die Suche, Aufbereitung und Bereitstellung von Wissen verbessern kann. Nun stellt sich zunehmend die Gegenfrage: Welche Anforderungen müssen Organisationen an ihre Informations- und Wissensbestände stellen, damit KI verlässlich mit ihnen arbeiten kann?
Wie anspruchsvoll diese Ausgangslage ist, zeigt die APQC-Studie „Knowledge Management Priorities and Trends 2026“, für die im November 2025 weltweit 164 Personen befragt wurden. 49 Prozent nennen die Integration von KI und intelligenten Technologien als eine ihrer wichtigsten Prioritäten für 2026, mehr als doppelt so viele wie bei der nächstgenannten Priorität. Gleichzeitig ordnen 59 Prozent ihr Wissensmanagement-Programm den beiden frühesten Reifestufen zu: 20 Prozent „am Anfang“ und 39 Prozent „in Entwicklung“. Weitere 40 Prozent sehen in einer Organisationskultur, die Wissensaustausch und Wiederverwendung nicht ausreichend fördert, eine wesentliche Bedrohung für den Erfolg des Wissensmanagements.
Die Ergebnisse belegen keine unmittelbare Kausalität zwischen geringer Wissensmanagement-Reife und schlechter KI-Qualität. Sie zeigen aber, dass wachsende KI-Ambitionen auf Organisationen treffen, in denen Wissensmanagement vielfach noch im Aufbau ist.
Besonders anschaulich wird das in Microsoft-365-Umgebungen. Eine Richtlinie liegt in mehreren SharePoint-Bibliotheken, eine überarbeitete Fassung wurde im Teams-Kanal geteilt und eine fachliche Ausnahme lediglich in einer Diskussion festgehalten. Mitarbeitende können diese Unterschiede möglicherweise einordnen, weil sie den Entstehungsprozess kennen oder die zuständige Person fragen. Ein KI-Assistent findet dagegen mehrere Versionen, ohne deren unterschiedliche Verbindlichkeit zuverlässig erkennen zu können.
Werden Informationen aus solchen Beständen extrahiert, zusammengefasst und weiterverwendet, können unklare Geltungsbereiche, widersprüchliche Aussagen und veraltete Inhalte in die Ergebnisse eingehen. Die technische Auffindbarkeit einer Information ist noch kein Nachweis ihrer fachlichen Gültigkeit.
Microsoft formuliert diese Anforderung für die eigene Plattform ausdrücklich. In der Anleitung zur Vorbereitung von SharePoint auf Copilot und Agenten wird empfohlen, Inhalte aktuell zu halten, deren Lebenszyklus zu verwalten, Berechtigungen zu überprüfen und übermäßige Freigaben zu vermeiden. Diese Aufgaben gewinnen an Bedeutung, wenn Copilot und Agenten auf vorhandene Unternehmensinformationen zugreifen. Wie sich Microsoft 365 Copilot zugleich zur Integrationsplattform für weitere Agenten und Anwendungen entwickelt, haben wir in einem früheren Beitrag eingeordnet.
Damit gewinnt eine bekannte Aufgabe des Informationsmanagements an Gewicht: Informationen müssen über ihren gesamten Lebenszyklus fachlich verantwortet werden. Entscheidend sind nicht allein Speicherort und Auffindbarkeit, sondern auch Herkunft, Gültigkeit, Aktualität und Zuständigkeit.
Warum wir Wissensorganisation differenzierter betrachten müssen
Eine Rückkehr zum klassischen Dokumentenmanagement folgt daraus nicht. Die Social-Collaboration-Debatte hat aus guten Gründen darauf hingewiesen, dass sich organisationales Wissen nicht vollständig dokumentieren lässt. Schon Ikujiro Nonaka beschrieb in seiner Arbeit „A Dynamic Theory of Organizational Knowledge Creation“ Wissensschaffung als Wechselspiel von implizitem und explizitem Wissen. Erfahrungswissen, situative Einschätzungen und die gemeinsame Entwicklung neuer Erkenntnisse bleiben auch für KI-gestützte Arbeit relevant. Welche Elemente ein organisatorischer Wissensmanagement-Ansatz dafür benötigt und wie digitale Werkzeuge dazu passen, haben wir in einem früheren Shift/Work-Beitrag beschrieben.
Die Informationsbestände in Unternehmen sind zudem sehr unterschiedlich organisiert. Neben Dokumentenbibliotheken und Wikis existieren fachliche Datenbanken, strukturierte Wissensobjekte, Diskussionsräume und informelle Wissensnetzwerke. Diese Formen erfüllen unterschiedliche Aufgaben und lassen sich nicht einfach als aufeinanderfolgende Entwicklungsstufen betrachten.
Für die Organisation expliziter Informations- und Wissensbestände lassen sich zwei Eigenschaften unterscheiden:
- Der Grad der expliziten Strukturierung: Werden Inhalte vorwiegend in Dokumenten und anderen zusammenhängenden Informationsartefakten vorgehalten, oder sind einzelne Aussagen, Fachbegriffe, Beziehungen und Geltungsbedingungen als strukturierte Informationsobjekte beschrieben?
- Die Dynamik der Fortschreibung: Werden Bestände überwiegend anlassbezogen gepflegt, oder existieren kontinuierliche Prozesse, mit denen Informationen aktualisiert, fachlich überprüft, ergänzt und bei Bedarf außer Kraft gesetzt werden?
Beide Dimensionen sind zunächst unabhängig voneinander. Ein Dokumentenbestand kann laufend aktualisiert und fachlich sorgfältig geprüft werden. Umgekehrt kann ein aufwendig strukturierter Wissensgraph veralten, wenn seine Inhalte nicht regelmäßig überprüft werden. Auch aus dezentralen Diskussionen können belastbare Erkenntnisse hervorgehen, sofern geklärt ist, wie diese erkannt und für die weitere Verwendung eingeordnet werden.
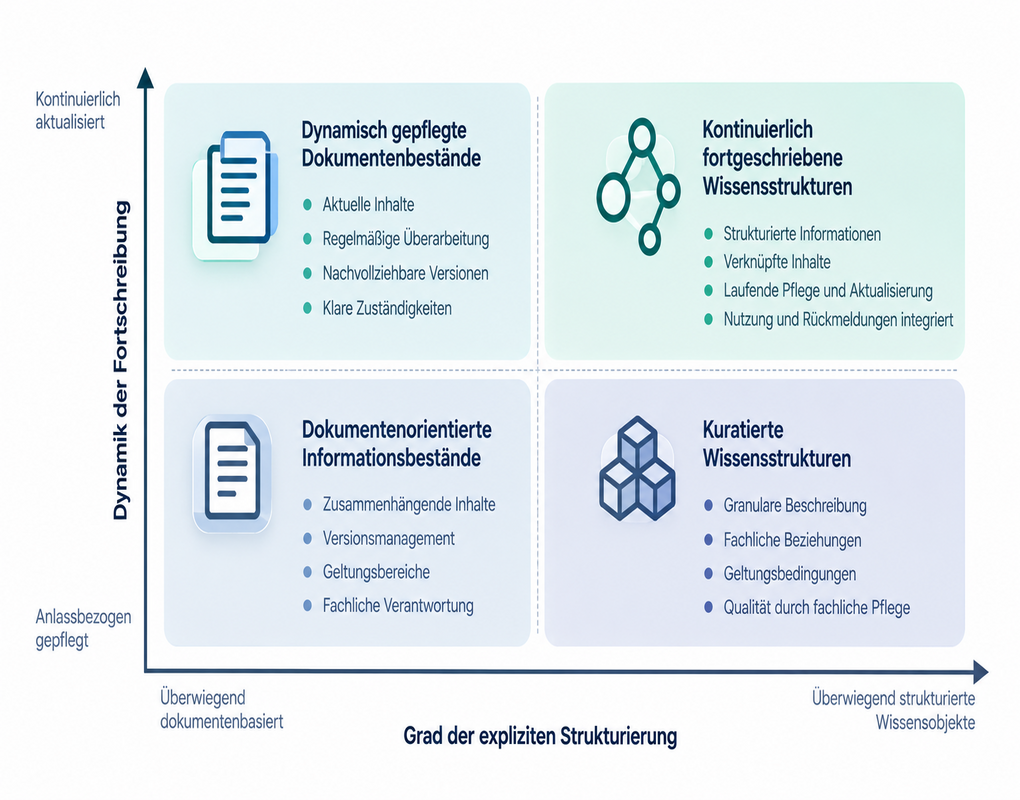
Zwei Dimensionen der Informations- und Wissensorganisation: horizontal der Grad der expliziten Strukturierung (Dokumente und zusammenhängende Artefakte bis strukturierte Informationsobjekte), vertikal die Dynamik der Fortschreibung (anlassbezogen bis kontinuierlich), mit den vier Konstellationen Dokumentenorientierte Informationsbestände, Dynamisch gepflegte Dokumentenbestände, Kuratierte Wissensstrukturen und Kontinuierlich fortgeschriebene Wissensstrukturen">
Eine Reifeleiter, an deren Ende zwangsläufig strukturierte und dynamisch fortgeschriebene Wissensobjekte stehen, ergibt sich daraus nicht. Vielmehr entstehen unterschiedliche Konstellationen mit jeweils eigenen Stärken und Herausforderungen:
- Dokumentenorientierte Informationsbestände stellen zusammenhängende fachliche Inhalte bereit. Entscheidend sind nachvollziehbare Versionen, Geltungsbereiche und Zuständigkeiten.
- Dynamisch gepflegte Dokumentenbestände verbinden dokumentenbasierte Inhalte mit regelmäßiger Überarbeitung. Hier stellt sich vor allem die Frage, wie Änderungen, fachliche Bestätigungen und historische Fassungen nachvollziehbar bleiben.
- Kuratierte Wissensstrukturen beschreiben Informationen granularer und stellen fachliche Beziehungen explizit her. Ihre Qualität hängt unter anderem von der fachlichen Pflege der Begriffe, Beziehungen und Geltungsbedingungen ab.
- Kontinuierlich fortgeschriebene Wissensstrukturen verbinden Informationsnutzung, Rückmeldungen und Aktualisierung enger miteinander. Sie benötigen verlässliche Verfahren, um neue Aussagen zu prüfen, Widersprüche zu erkennen und die Herkunft von Änderungen nachvollziehbar zu halten.
Welche Konstellation sinnvoll ist, hängt von der Art der Informationen und ihrer späteren Verwendung ab. Nicht jede Arbeitsnotiz muss zu einem semantisch beschriebenen Wissensobjekt werden. Und nicht jede Wissensdatenbank benötigt eine kontinuierliche Aktualisierung. Bei verbindlichen Richtlinien, sicherheitsrelevanten Anweisungen oder Informationen, die KI-Agenten für eigenständige Arbeitsschritte verwenden, liegen die Anforderungen an Gültigkeit und Qualität allerdings deutlich höher.
Wie sich Social Collaboration und strukturierte Wissensorganisation verbinden lassen
Mit der richtigen Informationsarchitektur ist es nicht getan. Informationen werden in Organisationen laufend erzeugt, interpretiert, diskutiert und verändert. Dafür haben Social Collaboration und Communities of Practice wichtige Grundlagen gelegt.
Ein Beispiel: In einem Teams-Kanal diskutieren mehrere Fachverantwortliche eine Ausnahme von einem etablierten Prozess. Aus unterschiedlichen Erfahrungen entsteht eine neue fachliche Einschätzung. Für die Beteiligten ist nachvollziehbar, welche Annahmen dahinterstehen und unter welchen Bedingungen das Ergebnis gilt. Ein KI-Assistent, der später auf den Gesprächsverlauf zugreift, kann diesen Kontext möglicherweise nicht ausreichend einordnen.
Soll eine solche Erkenntnis über den ursprünglichen Gesprächskontext hinaus verwendet werden, stellen sich zusätzliche Fragen: Handelt es sich um eine verbindliche Regel oder eine vorläufige Einschätzung? Wer hat die Aussage fachlich bestätigt? Für welche Fälle gilt sie? Und wie wird sie aktualisiert, wenn sich die Rahmenbedingungen verändern?
Dafür müssen Organisationen nicht sämtliche Kommunikation formalisieren. Sie benötigen aber Verfahren, mit denen relevante Erkenntnisse aus der Zusammenarbeit erkannt, fachlich eingeordnet und bei Bedarf in verlässliche Informations- und Wissensbestände überführt werden können. Das betrifft insbesondere Informationen, die später als Grundlage automatisierter Verarbeitung oder agentischer Entscheidungen dienen.
Die Aufgabe liegt damit an der Schnittstelle zwischen sozialer Wissensentwicklung und expliziter Wissensorganisation. Die Offenheit kollaborativer Prozesse ermöglicht neue Erkenntnisse. Ihre spätere Wiederverwendung benötigt dagegen ausreichend nachvollziehbare Aussagen über Herkunft, Bedeutung, Verbindlichkeit und Gültigkeit.
Wenn KI-Agenten selbst neue Wissensbestände schaffen
Eine zusätzliche Herausforderung haben wir im zweiten Teil unserer Serie zur Orchestrierung agentischer Arbeit aufgegriffen: Agenten verwenden nicht nur bestehende Informationen, sondern können eigene Ergebnisse, Erfahrungen und Arbeitskontexte für spätere Aufgaben speichern.
Claude Code zeigt, wie solche Mechanismen bereits in der Praxis eingesetzt werden. Laut der Dokumentation zum Kontextgedächtnis unterscheidet das System zwischen persistenten Projektanweisungen in CLAUDE.md-Dateien und automatisch angelegten Erinnerungen (Auto Memory). Diese können Erkenntnisse aus früheren Aufgaben, Projektkontext und wiederkehrende Korrekturen enthalten. Bei späteren Ausführungen fließen solche Informationen erneut in den Kontext des Agenten ein.
Damit entsteht ein neuer Wissenskreislauf. Ein Agent bearbeitet eine Aufgabe, erzeugt ein Ergebnis und hält gegebenenfalls eine daraus abgeleitete Erfahrung fest. Wird diese Erfahrung später erneut genutzt, kann sie weitere Arbeitsschritte beeinflussen. Eine zunächst unsichere Annahme oder eine nur situativ sinnvolle Vorgehensweise kann dadurch über mehrere Aufträge hinweg wirksam bleiben.
Das bedeutet nicht, dass Agenten durch das Speichern einer Erinnerung automatisch ein Reinforcement Learning ihrer Modellgewichte durchführen. Die Veränderung erfolgt vielmehr auf der Ebene des persistenten Kontexts. Für die Wissensorganisation ist das dennoch relevant: Informationen, die ursprünglich nur aus einer einzelnen Bearbeitung stammen, können bei späteren Aufgaben den Charakter einer wiederverwendbaren Arbeitsgrundlage erhalten.
Besonders problematisch wird dies, wenn der fachliche Status solcher Informationen unklar bleibt. Eine erfolgreich abgeschlossene Aufgabe bestätigt nicht zwangsläufig, dass sämtliche dabei verwendeten Annahmen und Vorgehensweisen korrekt waren. Wird eine fragwürdige Praktik als bewährtes Muster gespeichert, kann sie sich in folgenden Bearbeitungen verfestigen.
Daraus ergeben sich neue Anforderungen an die Governance agentischer Wissensbestände. Originäre Quellen, fachlich geprüfte Erkenntnisse, KI-generierte Ableitungen und automatisch gespeicherte Erfahrungen müssen unterscheidbar bleiben. Ebenso wichtig ist, wer neue Einträge bestätigen, verändern oder außer Kraft setzen kann und wie sich ihre Herkunft nachvollziehen lässt.
Die Frage betrifft auch KI-gestützte Wissenssysteme, die Informationen aus unterschiedlichen Quellen zusammenführen. Ein systematischer Literaturreview von Karakurt und Akbulut zu Retrieval-Augmented Generation im Enterprise Knowledge Management beschreibt eine Lücke zwischen der wissenschaftlichen Erprobung solcher Systeme und ihrer langfristigen Integration in produktive Unternehmensprozesse. Die Sicherung von Qualität, Nachvollziehbarkeit und Governance bleibt dabei eine wesentliche Herausforderung.
Wie sich die Qualität KI-gestützter Arbeitsergebnisse organisatorisch absichern lässt, haben wir bereits in unserer Serie AI Governance @ Work: Warum KI-Qualität zur Managementaufgabe wird diskutiert. Für die Wissensorganisation kommt die Frage hinzu, welche Ergebnisse und Erfahrungen überhaupt dauerhaft zur Grundlage weiterer Arbeit werden dürfen.
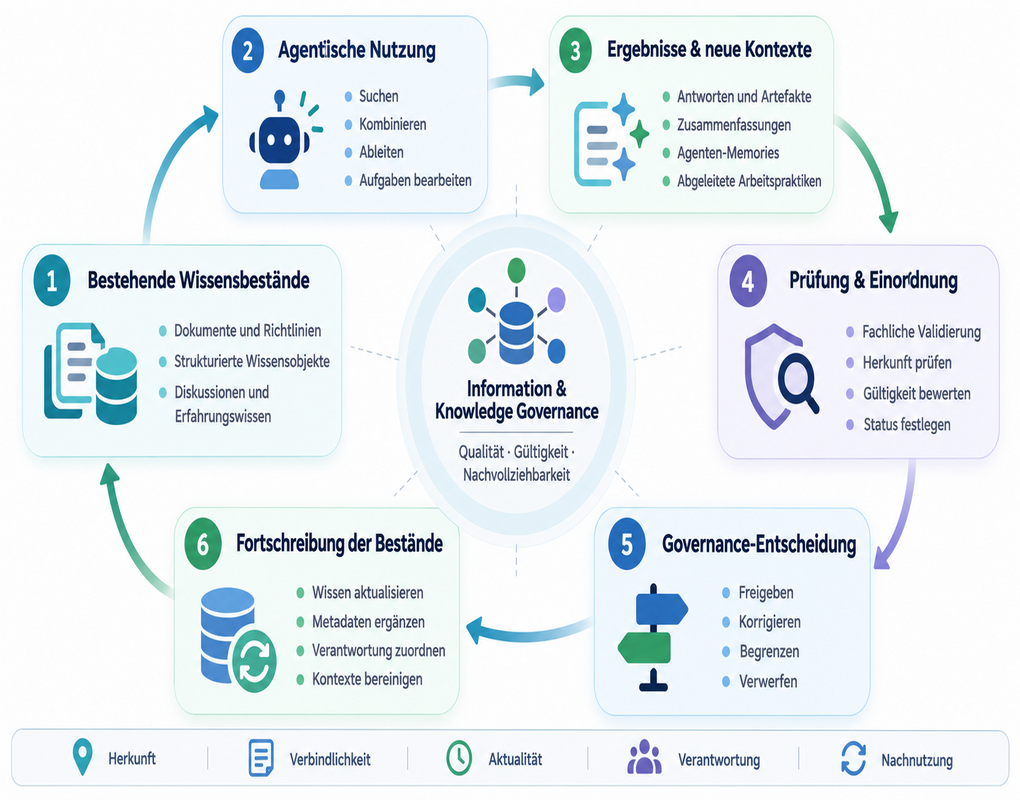
Wissensmanagement muss damit zwei miteinander verbundene Aufgaben erfüllen: die Verlässlichkeit bestehender Informationsbestände sichern und die Entstehung, Bewertung und Fortschreibung neuer Wissensbestände durch KI-gestützte Arbeit gestalten.
Information & Knowledge Governance wird zur organisationalen Aufgabe
Mit KI kehren die alten Informationssilos nicht zwangsläufig zurück. Zusammenfinden müssen vielmehr zwei Anforderungen, die lange getrennt betrachtet wurden: die Offenheit und Dynamik sozialer Wissensprozesse und die Verlässlichkeit explizit organisierter Informationsbestände. Hinzu kommt eine dritte Anforderung: die Kontrolle von Wissensbeständen, die automatisiert entstehen und später erneut in die Arbeit einfließen.
Damit schließt sich auch der Argumentationsbogen unserer Serie From Knowledge Work to Agentic Work. Im ersten Teil haben wir beschrieben, wie sich die menschliche Wissensarbeit durch die Delegation von Aufgaben an Agenten verändert. Im zweiten Teil ging es um die Orchestrierung hybrider Arbeitssysteme, verbindliche Handlungsgrenzen und menschliche Aufsicht. Der dritte Teil ergänzt die Voraussetzungen auf der Wissensebene: Agenten benötigen fachlich gültige Informationsgrundlagen, während ihre eigenen Ergebnisse und Erfahrungen wiederum neue Anforderungen an die Wissensorganisation schaffen.
Zusätzliche Metadaten oder neue technische Strukturen reichen dafür allein nicht aus. Organisationen müssen fachliche Verantwortlichkeiten, Qualitätskontrollen, Aktualisierungsprozesse und Regeln für die Weiterverwendung von Informationen festlegen. Das betrifft vorhandene Dokumentenbestände ebenso wie strukturierte Wissensobjekte, kollaborativ entwickelte Erkenntnisse und persistente Agentenkontexte. Warum KI-Governance klare organisatorische und technische Leitplanken benötigt, haben wir bereits in Governance für Copilot & Co. beschrieben.
Für Verantwortliche im Digital Workplace ergeben sich daraus fünf Untersuchungsfragen:
- Welche Informations- und Wissensbestände werden heute tatsächlich für KI-gestützte Arbeit verwendet?
- Wo fehlen fachliche Verantwortlichkeiten, nachvollziehbare Geltungsbedingungen oder verlässliche Angaben zur Aktualität?
- Welche Informationen müssen regelmäßig überprüft oder kontinuierlich fortgeschrieben werden?
- Wie lassen sich Erkenntnisse aus der Zusammenarbeit für die spätere Verwendung verfügbar machen, ohne ihren ursprünglichen Kontext zu verlieren?
- Welche KI-generierten Ergebnisse, Agenten-Memories und abgeleiteten Arbeitspraktiken werden dauerhaft gespeichert, und wie wird ihre fachliche Gültigkeit überprüft?
Diese Fragen bilden auch den Ausgangspunkt unseres Shift/Work-Assessments Information & Knowledge Governance für KI @ Work. Es unterstützt dabei, die bestehende Informations- und Wissensorganisation strukturiert zu untersuchen: von der Organisation und Pflege der Bestände über Zugriffs- und Gültigkeitsfragen bis zu fachlichen Verantwortlichkeiten. Auf Basis der Angaben werden Zusammenhänge, mögliche Problembereiche und weiterführende Untersuchungsfragen sichtbar.
Zum Assessment Information & Knowledge Governance für KI @ Work
Die übergreifenden Fragen zur Gestaltung KI-gestützter Arbeitsumgebungen, zur Digital Workplace Governance und zur Verbindung von Zusammenarbeit, Wissen und neuen Arbeitsmodellen diskutieren wir auch beim Shift/Work Smart Work & Employee Communications SUMMIT am 12. November 2026.
Content Newsletter
Immer über die neuesten Beiträge informiert
Immer über die neuesten Beiträge informiert
- Zugang zu Freemium-Inhalten der Mediathek
- Drei Credits für Freischaltung von Premium-Inhalten
- Monatlicher Content-Newsletter mit Premium-Inhalten
- Zugang zu geschlossener Linkedin-Gruppe
- Besondere Plattform-Angebote über Shift/Work Updates
- Kostenlos für immer!
Wir legen großen Wert auf sachliche und unabhängige Beiträge. Um nachvollziehbar zu machen, unter welchen Rahmenbedingungen unsere Inhalte entstehen, geben wir folgende Hinweise:
- Partnerschaften: Vorgestellte Lösungsanbieter können Partner oder Sponsoren unserer Veranstaltungen sein. Dies beeinflusst jedoch nicht die redaktionelle Auswahl oder Bewertung im Beitrag.
- Einsatz von KI-Tools: Bei der Texterstellung und grafischen Aufbereitung unterstützen uns KI-gestützte Werkzeuge. Die inhaltlichen Aussagen beruhen auf eigener Recherche, werden redaktionell geprüft und spiegeln die fachliche Einschätzung des Autors wider.
- Quellenangaben: Externe Studien, Daten und Zitate werden transparent kenntlich gemacht und mit entsprechenden Quellen belegt.
- Aktualität: Alle Inhalte beziehen sich auf den Stand zum Zeitpunkt der Veröffentlichung. Spätere Entwicklungen können einzelne Aussagen überholen.
- Gastbeiträge und Interviews: Beiträge von externen Autorinnen und Autoren – etwa in Form von Interviews oder Gastbeiträgen – sind klar gekennzeichnet und geben die jeweilige persönliche Meinung wieder.